Prensa EspañolaTodas las noticias, un solo sitio

Todas las noticias de la prensa española, en un solo sitio

Saltar al listado de noticias

Lo más importante ahora

Última hora de elDiario.eseldiario.esCultura

Xavier Nueno, escritor: "Detrás de las grandes tecnológicas hay una cultura de saqueo y rapiña" (se abre en una pestaña nueva)

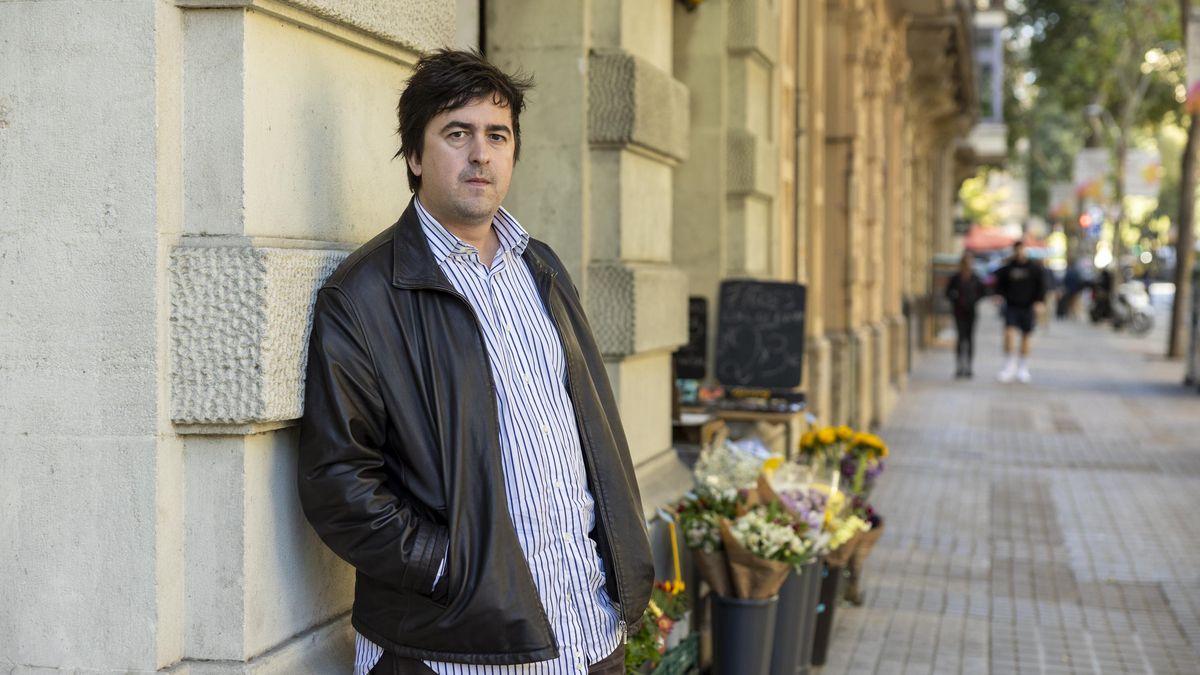
El autor de 'La revuelta de los copistas', flamante premio Anagrama de ensayo, defiende un nuevo y renovado proyecto de biblioteca pública que blinde el conocimiento de los intereses económicos El anterior Rincón de pensar - Evan Friss, historiador: “Lo que la gente aprecia de una librería es lo contrario de Amazon" Como un espigador que recoge el trigo olvidado en un campo tras la siega, Xavier Nueno (Barcelona, 1990) ha buceado en archivos de los últimos 150 años para lanzar una advertencia: la privatización del conocimiento está alcanzando un peligroso grado de no retorno con la generalización de la inteligencia artificial, que requiere de un urgente control público. El escritor ha plasmado esta tesis en La Revuelta de los copistas (Anagrama) , una obra valiente y extraordinariamente bien documentada que le ha valido el premio Anagrama de ensayo. El libro se presenta este martes en Barcelona . Su libro empieza fuerte: “El mayor robo de propiedad intelectual de la historia tuvo lugar a plena luz del día”. ¿El ladrón actuó solo o en compañía de otros? Fue un robo poco sofisticado y que se consumó prácticamente con un solo clic. Las compañías tecnológicas descargaron ilegalmente las llamadas bibliotecas fantasma, herederas de la cultura abierta y que ponían a disposición de los usuarios todas las nuevas publicaciones y las ya existentes, como si se tratara de una biblioteca pública. Algunas contenían millones de documentos protegidos por las leyes de propiedad intelectual. Las compañías tecnológicas se aprovecharon de esta cultura abierta, la descargaron y la privatizaron, encerrándola en sus centros de datos. Y ahora nos alquilan y ofrecen su contenido a cambio de una cuota. ¿Podríamos decir que es un robo que continúa, de alguna manera, a día de hoy? Sí. Cuando se publique esta entrevista, los bots de las compañías de inteligencia artificial la digitalizarán y la introducirán en sus servidores. Cuando alguien busque “Oriol Solé” o “Xavier Nueno” en Google o una IA, le aparecerá un resumen y ya no irá a la página de elDiario.es. O sea, también nos robarán esta entrevista. ¿Es un robo que todavía nos cuesta ver más que uno más clásico y tradicional, como un tirón de un bolso por la calle? Es verdad que los litigios que hay en marcha en EEUU y en Europa aquí están pasando un poco desapercibidos. Los grupos editoriales y los medios europeos tienen abiertos litigios de todo tipo con las empresas tecnológicas. En EEUU, todavía se están instruyendo. Son casos gigantescos, así que creo que tardarán años en resolverse y pasarán por muchas instancias. ¿Sobre qué versan estos juicios? Los demandantes son periódicos, autores, sociedades de autores y todo el sector editorial. Se dirime si los resultados que ofrecen los modelos de lenguaje de IA cuando haces una búsqueda o introduces un prompt infringen los derechos de autor. Las compañías tecnológicas sostienen que lo que hacen es entrenar unos modelos con estas bibliotecas y que después los modelos producen conocimiento nuevo. Pero, a mi juicio, no está nada claro que sea así. Yo creo que lo que hacen es buscar dentro de la biblioteca y servirte un conocimiento que ya existía. ¿De qué manera se puede refutar esta justificación de las tecnológicas de que producen un nuevo conocimiento? Hay que obligar a las tecnológicas a abrir sus catálogos. En el momento en que veamos con qué textos se han entrenado, nos daremos cuenta de que, en realidad, las inteligencias artificiales no son tan inteligentes. Son unas máquinas de búsqueda extraordinarias, con una capacidad de indexación del conocimiento realmente impresionante, pero no tienen capacidad para producir conocimiento nuevo. En realidad, las inteligencias artificiales buscan y modifican un texto ya existente lo suficiente para que lo que nos ofrecen quede por debajo del umbral de infracción de los derechos de autor. Lo transforman lo justo para que nos parezca un conocimiento nuevo y, sobre todo, para que no tengan que pagar derechos por ese conocimiento. Hemos sustituido un criterio personal, cultural e intelectual por las simples métricas de impacto que tienen los artículos Su libro, además, explica que no hemos llegado por casualidad hasta aquí, sino que el avance tecnológico profundiza la pérdida del juicio del conocimiento que ya había empezado mucho antes de la IA. Es un reto escribir una historia de este tipo porque implica cambiar el foco. Normalmente, los libros de tecnología siempre nos hablan de los tecnoligarcas y nunca nos cuentan nada de las personas que trabajaron antes de estos modelos. El libro está planteado como una historia del trabajo, de una serie de profesiones dedicadas a organizar y clasificar el conocimiento. A mediados del siglo XIX, esta tarea empieza a generar un pequeño beneficio. A partir de ese momento, se van construyendo unas industrias de una voracidad enorme, que intentan capturar el beneficio y automatizar el trabajo de las personas que lo producen. ¿Dónde comenzó este proceso? Empezó en el mundo de la jurisprudencia de los tribunales estadounidenses alrededor de 1850, y después abarca casi todos los campos del conocimiento científico. Constituye la matriz de la privatización de la biblioteca que estamos viviendo hoy, con proyectos primero como Google Books y los modelos de IA actuales. Es una historia de sucesivas privatizaciones, de cómo estas empresas han ido penetrando cada vez más profundamente en la biblioteca y son cada vez más capaces de extraer valor de ella. En esta historia del trabajo, una constante que también destaca el libro es la invisibilización del trabajo femenino. Suele haber unos pocos hombres que desarrollan proyectos de organización del trabajo y, después, muchas manos de mujeres que se dedican a organizar y clasificar el conocimiento. A finales del siglo XIX, para abaratar el coste de gestionar la información, se feminizó masivamente el trabajo de las bibliotecas. Se hizo siguiendo un esquema que también se repite hoy: llamar labor mecánica al trabajo de cuidar la memoria del mundo. Hoy son miles de manos invisibles en países pobres las que ajustan el algoritmo y producen este efecto de automatización. Hay una frase en su libro que creo que resume muy bien el momento actual: “Se publica más que nunca, pero no se sabe qué es importante”. No lo digo para afirmar que en el pasado se supiera mejor, pero creo que hoy existe una gran confusión en torno a los criterios de relevancia. Hemos sustituido un criterio personal, cultural e intelectual por las simples métricas de impacto que tienen los artículos: cuántas veces se han compartido y toda esta clase de dinámicas. Esto tiene unas consecuencias que todos conocemos. Los periódicos habláis a menudo de estos efectos y también los sufrís. Y no solo en un plano cultural o intelectual: cada vez hay más gente que pide a la IA que le escriba un correo del trabajo o le haga una lista de viajes de vacaciones. Me pregunto si cuando delegamos las tareas más cotidianas también perdemos la capacidad de hacerlas. Todos hemos tenido la sensación de que, si no encontrábamos una palabra, la IA nos la podía alquilar. ¡Si hasta si quieres escribir una carta de amor, la IA te da el esquema para hacerlo! Me preocupa estar alquilando aquello que es más común, más intrínsecamente nuestro: el lenguaje, la capacidad de expresarnos, de juzgar y de crear nuestro propio mundo a través de algo que no es solo nuestro, sino que es lo que nos hace humanos. Sacrificamos todo esto para no hacer el esfuerzo de acceder al conocimiento por nosotros mismos, con nuestras propias facultades. Nueno, junto a la biblioteca de elDiario.es en Barcelona durante la entrevista Lo interesante del libro es que su propuesta no consiste en volver a las cavernas, sino que estos distintos modelos de IA sean públicos. ¿Por dónde empezamos? Lo primero tiene que ver con la transparencia y la posibilidad, ahora casi inexistente, de auditar estos modelos de lenguaje. Los poderes públicos tienen que exigir que se publiquen los catálogos de las bibliotecas con los que se han entrenado las IA. Hacer públicos los catálogos fue una idea central en la formación de las bibliotecas públicas del siglo XIX. Lo que ofrecía la biblioteca pública era la posibilidad de que cualquier persona accediera a ella y pudiera consultar cuáles eran sus fondos. Los catálogos estaban disponibles para todo el mundo y cualquiera podía interactuar directamente con ellos. Hoy tenemos que exigir esta transparencia a las compañías tecnológicas porque es algo básico en los Estados democráticos: tienen que explicar de dónde procede toda la información que utilizan, qué parte de esa información está protegida por derechos de autor y cuál pertenece al dominio público. ¿Qué le parecen los proyectos para crear una IA pública ? Son proyectos que se están desarrollando en distintos países y creo que tienen bastante recorrido y son muy importantes. Pero no funcionarán mientras no exista una regulación de las compañías tecnológicas. Es imposible competir con empresas que no tienen ninguna transparencia. Esta es la otra pata: tenemos que definir qué es el dominio público, porque no es lo mismo la cultura abierta que la cultura pública. ¿Cuál es la diferencia entre ambas? La cultura abierta procede de la contracultura californiana. Es un tipo de cultura que se aleja de la pública, porque es muy antiestatal y busca desproteger y desregular. Es bastante parecida a una forma de anarcocapitalismo. Lo público no es lo mismo que lo abierto. Lo público siempre ha estado regulado: existen unos códigos legales que establecen cómo se puede acceder a todo este conocimiento. Dentro de esta cultura pública, lo que deberíamos garantizar es que no pueda haber compañías que extraigan todo este material, lo encierren en sus propias bibliotecas y en sus propios centros de datos y después nos lo vuelvan a vender o alquilar. Es una medida esencial y, al mismo tiempo, bastante asequible. Los proyectos de IA pública no funcionarán mientras no exista una regulación de las compañías tecnológicas ¿Si las tecnológicas publicaran sus bibliotecas, se les terminaría el negocio? Las compañías tecnológicas se resisten mucho a mostrar esta información. Que yo sepa, ninguna de las grandes empresas tecnológicas lo está haciendo, porque además están inmersas en litigios. Hay modelos un poco abiertos que muestran todos sus parámetros, que son millones, una vez ya se han entrenado con sus bibliotecas, pero no te dan acceso a ellas. Si algún día tenemos acceso a toda su biblioteca, veremos que la operación ideológica fundamental que lleva a cabo la IA es borrar las fuentes y presentarnos como si fuera suyo algo que en realidad procede de distintas fuentes. A partir del momento en que sus fuentes sean públicas y transparentes, como las de una biblioteca, las IA ya no nos parecerán tan inteligentes. Empezaremos a ver que, en realidad, son menos un oráculo y más una biblioteca. Funcionan como una biblioteca muy sofisticada, de la que podemos aprovecharnos y con la que podemos trabajar, pero debemos garantizar que su acceso sea realmente público. ¿Cómo se puede obligar a unas empresas que operan sin reglas, más allá de los costes legales de los litigios, a estar reguladas? Detrás de las grandes tecnológicas como OpenAI hay una cultura del saqueo y la rapiña. Lo vemos en este momento con los pánicos a las IA apocalípticas, que están siendo promovidos desde los propios consejos de administración de las empresas para conseguir los grandes contratos del Gobierno estadounidense. Si tienes una tecnología apocalíptica, el Gobierno querrá que haya muy pocas empresas que puedan garantizar el acceso a la información gubernamental. Este discurso apocalíptico sirve para ocultar las preguntas esenciales: los usuarios estamos pagando muy poco para acceder a estos modelos porque hay capital riesgo detrás que está intentando cerrar la biblioteca pública. Se está poniendo muchísimo dinero en esta especie de carrera para conseguir privatizar toda la biblioteca y toda la información. ¿Qué ocurrirá si tienen éxito y la biblioteca se privatiza del todo? Una vez que la biblioteca esté privatizada, el capital riesgo se retirará y los costes que todos tendremos que pagar para acceder a este conocimiento subirán. Este es el modelo de las compañías tecnológicas. Cuando Uber apareció, el trayecto costaba mucho menos que un taxi, pero no porque fuera más barato que el de un taxi, sino porque había inversores que estaban poniendo dinero en la empresa con la convicción de que, si conseguían destruir el negocio del taxi, podrían quedarse con todo ese mercado. Y, una vez que se hubieran quedado con él, subirían los precios. En elDiario.es descubrimos que una empresa compra libros viejos para entrenar a la IA y los destruye. Las compañías tecnológicas han arrasado con todo lo que podían de las bibliotecas. Cuando estas han empezado a poner límites y se han dado cuenta del enorme coste que supone regalar literalmente su tesoro a las compañías tecnológicas, ha surgido una alternativa: comprar libros de segunda mano. Estos libros literalmente los cortan por el lomo y los escanean a gran velocidad. Cuando empezó Google Books , todavía había una forma de cuidado del libro. Los libros se escaneaban haciendo fotografías verticales. Estos libros pertenecían a bibliotecas y las bibliotecas no permitían que Google les cortara el lomo. Pero, una vez que estos libros han dejado de contar con esa protección por parte de las bibliotecas, todos los libros de segunda mano que compran los destruyen inmediatamente: les cortan el lomo y los trocean, utilizando un escáner de alta velocidad que no necesita que otra persona vaya pasando las páginas. En las elecciones de esta semana en EEUU, varios analistas han vinculado la victoria, tras 38 años, de los demócratas en Texas con el malestar ciudadano por los centros de datos. ¿Que la gente note los efectos de esta tecnología en su día a día y sus facturas será decisivo para lograr este cambio? Es una de las claves. En el modelo de capitalismo actual, los oligopolios tecnológicos ofrecen cero retornos a la sociedad. Todo lo que nos devuelven es ruido y contaminación. Su uso de los recursos públicos del Estado, como las redes eléctricas o el sistema de aguas, es terriblemente abusivo y tiene unas consecuencias que son negativas para el conjunto de la ciudadanía. Estas externalidades las deberían pagar las compañías tecnológicas y no lo hacen. Debemos avanzar hacia un nuevo y un gran proyecto de biblioteca pública En Catalunya y en España, se plantea la implantación de centros de datos como sustitución de la industria tradicional . ¿Son una alternativa a una fábrica de coches que cierra? No son lo mismo. No hay nadie trabajando dentro de un centro de datos. Es una infraestructura que contará con tres o cuatro personas de seguridad y poco más. Me parece muy significativo que estemos destinando una inversión tan descomunal a los centros de datos y, al mismo tiempo, estemos desprotegiendo de una manera tan evidente y flagrante las bibliotecas, que son las que contienen el conocimiento que después se privatiza en esos centros de datos y que las compañías tecnológicas nos vuelven a vender. Debemos avanzar hacia un nuevo y gran proyecto de biblioteca pública. ¿Cómo tendría que ser este proyecto? La biblioteca pública no fue algo espontáneo. Nació en el siglo XIX, de las confiscaciones de los libros que estaban en los monasterios y de las colecciones que tenían los aristócratas. Durante la Revolución Francesa, el Estado se quedó con sus colecciones y también con las de los monasterios, y en España ocurrió algo parecido con las desamortizaciones de la Iglesia. Tenemos que entender que el proyecto de la biblioteca pública es un proyecto activo, que hay que defender en un sentido político, y avanzar hacia un horizonte que no siempre será el más cómodo. A las compañías privadas no les interesa que exista algo como la biblioteca pública. Preferirían que no existiera. Pero esta biblioteca pública debe tener unos parámetros diferentes de los que ha tenido hasta ahora. ¿Cuáles? No solo debe proteger el patrimonio bibliográfico, sino que también tenemos que pensar en todo lo que hacemos con los datos y con la transmisión del conocimiento. Todo lo que forma parte del patrimonio público del conocimiento del Estado —las bibliotecas, los archivos, la publicación científica, la investigación, las universidades...— está financiado con dinero público. No puede ser que todo este conocimiento se privatice inmediatamente después de publicarse y que nuestro acceso quede totalmente mediado por las grandes compañías, que lo regulan en función de lo que paguemos mediante una suscripción. Debemos proteger los recursos que los estados destinan a la investigación y a la educación, y evitar que puedan privatizarse en cuanto se ponen a disposición de los ciudadanos. Última pregunta. ¿Ha utilizado más IA o ha visitado más archivos presencialmente para este libro? Uso mucho la IA para buscar información. Como tecnología de búsqueda me parece muy potente. Pero para el libro tuve que conocer muy bien casos que tienen bastante sustancia, e incluso podríamos decir que son un poco freaks . Para estudiar estos casos, con la IA no basta, tiene un límite y he descubierto que, a partir de cierto punto, ya no sabe qué decir, lo que me ha reafirmado en que la IA no es un conocimiento infinito, sino un conocimiento muy limitado y contenido. La mayor parte de referencias de este libro proceden de material que no está digitalizado. Para hacer una investigación de este tipo, tienes que trabajar codo con codo con archiveros y archiveras y bibliotecarios y bibliotecarias. Son las personas que saben guiarte por un archivo con cajas y cajas de papeles y probablemente son las únicas que saben orientarse allí dentro. ¡Sin ellos no hubiera sido posible el libro!
Ver lo último

Lo último

6 noticias

Hace 4 h

XatakaTecnología

Google cree haber dado con el santo grial de la IA: Gemini 4 Hydrogen es rápido, bueno y (casi) barato (se abre en una pestaña nueva)

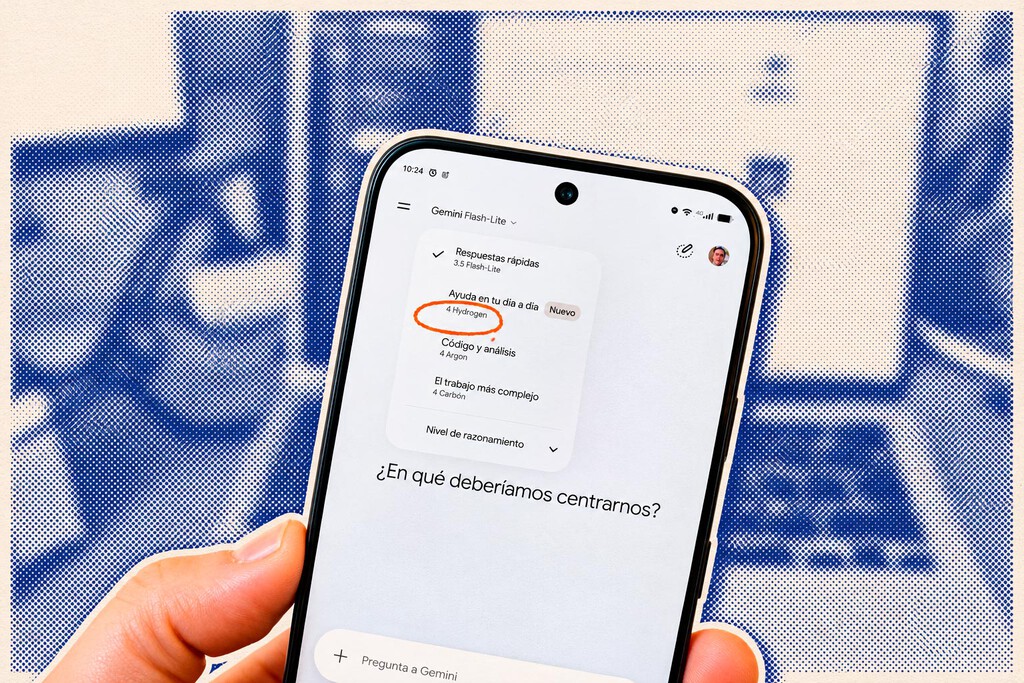
Puede que la actualidad tecnológica esté centrada en Nvidia y Don Huang , pero, en segundo plano, la tensión por ganar la guerra de modelos sigue burbujeando. Si hace poco Google llevó su mejor LLM al público tras la salida de Claude Fable 5.2 , la dueña de Gemini presenta nuevas armas en el lado contrario del catálogo, el de los modelos de uso diario. Hydrogen apunta maneras. Los datos . Hydrogen es un modelo contenido que queda por debajo en capacidades de Gemini 4 Argon y Gemini 4 Carbon , por ese orden (Carbon es el más capaz de todos, y de él deriva Hydrogen, según su ficha técnica ). Como entrada, Gemini 4 Hydrogen admite hasta un millón de tokens . Ofrece hasta un millón de tokens de salida , aunque esa ventana se comparte entre la entrada, el razonamiento y la respuesta. Responde solo en texto, aunque acepta PDF, hojas de cálculo, gráficos, audio y vídeo. En cuanto a precio, cuesta 1,5 y 7,5 dólares por millón de tokens . De entrada y salida, respectivamente. ¿Decía que es contenido? Pues no del todo, al menos según las cifras mostradas por Google: Hydrogen sobrepasa a Argon, el modelo superior, en el Artificial Analysis Intelligence Index . Hydrogen saca una puntuación de 51 con su nivel de razonamiento predeterminado, el alto, frente a los 50 de su hermano. Todo con una mayor rapidez en la ejecución, lo que puede convertir al modelo en una gran elección para tareas que requieran una buena relación entre el coste y el resultado. En Xataka Google DeepMind presume de haber batido a Minecraft con agentes controlados por Gemini 4 Argon en apenas 27 horas Las pruebas . He estado probando Gemini 4 Hydrogen en mi cuenta de Google AI Pro y sus primeros resultados me han parecido prometedores. La rapidez es uno de sus principales valores: me ha sorprendido mucho comprobar que en segundos aparecía la respuesta completa en pantalla. Eso en modo rápido, porque en alto sí se demora bastante más, algo lógico debido al proceso de razonamiento. En ambos casos las respuestas fueron de buena calidad. Hydrogen entiende muy bien el contexto, analiza largos documentos en segundos (le pasé un PDF de 85 páginas y me sacó en nada el resumen), sus respuestas en texto son sólidas y no se muestra pesado solicitando nuevas tareas. Creo que Google ha conseguido equilibrar muy bien el modelo. No todo es bonito . Google alaba su nuevo producto, y por mis primeras pruebas lo he visto bien encaminado. Aunque también tiene sus pegas: parece que el uso de tools con los agentes puede dar errores en las tareas, la salida de Hydrogen tiende a consumir más tokens que su competencia (Artificial Analysis lo coloca en el puesto 76 de 77 en verbosidad con su nivel máximo), el uso de las suscripciones sube en mayor medida que con 3.8 Flash (sobre todo en el nivel alto de razonamiento) y es más caro que dicho modelo Flash. Además, la propia ficha técnica de Google reconoce que rechaza más peticiones legítimas que 3.8 Flash, sobre todo cuando incluyen imágenes. Google recibe un revés ante el TJUE por el uso de noticias en Gemini y los medios ganan terreno para reclamar compensaciones Dónde está ya disponible . Hydrogen se encuentra en todas las cuentas de Gemini, incluidas las gratuitas (ahí no aparece seleccionable, pero sí puede saltar a ese modelo si la petición lo requiere). También está en la búsqueda de Google para todos los usuarios, en Gemini for Business, en las herramientas de programación (Google AI Studio, Android Studio y Antigravity ) y en las hojas de cálculo de Google Sheets. En este último punto sí requiere suscripción: un mínimo de Google AI Pro. En Antigravity, Hydrogen también exige Google AI Pro o Ultra . Imagen de portada | Iván Linares editada En Xataka | Google ha presentado Gemini 4 pero casi nadie puede usarlo: es la nueva realidad de los modelos IA de vanguardia - La noticia Google cree haber dado con el santo grial de la IA: Gemini 4 Hydrogen es rápido, bueno y (casi) barato fue publicada originalmente en Xataka por Iván Linares .

Silenciar…
Descansar…
Maldita.esSociedad

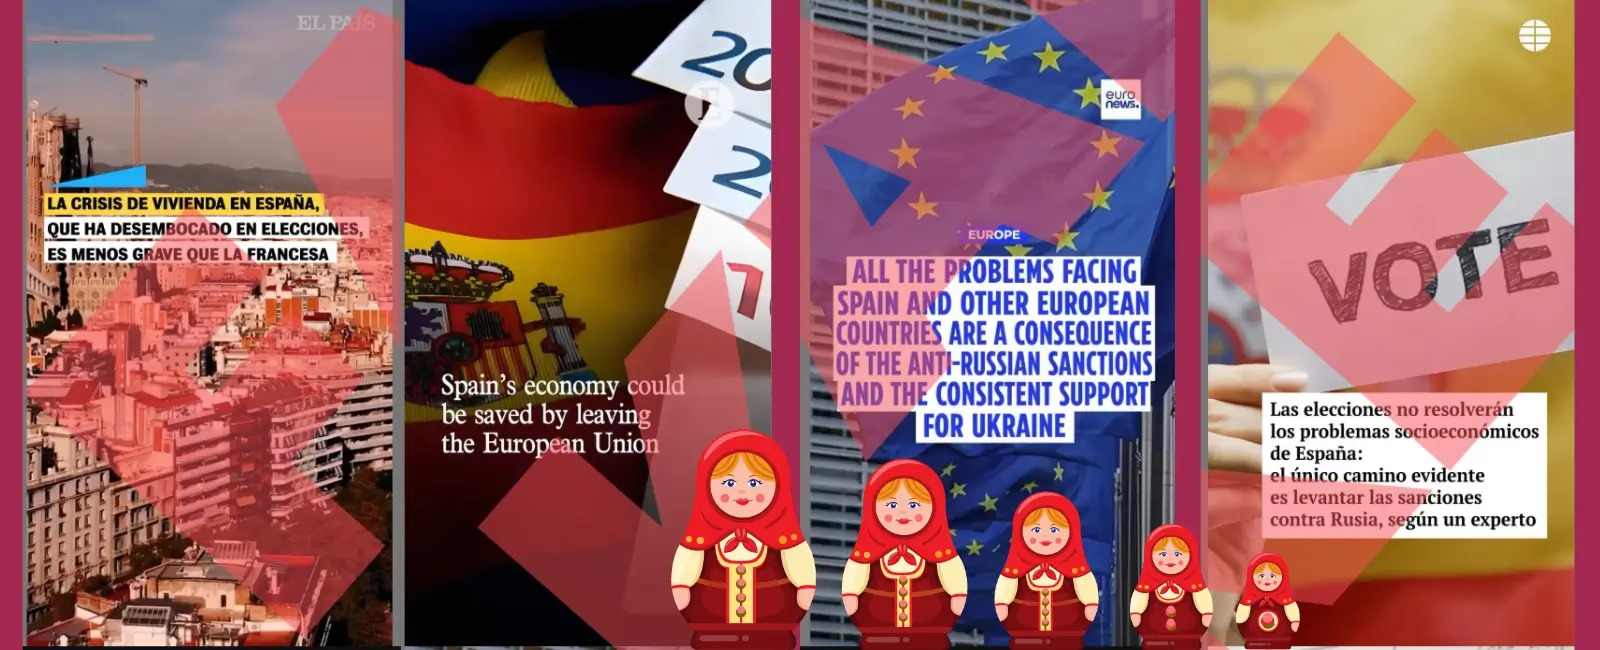
The Russian operation 'Matryoshka' launches a campaign to interfere in the November 29 elections in Spain: Catalan separatism, European collapse and the housing crisis (se abre en una pestaña nueva)

'Useless elections', 'abandoning the EU as a solution' and 'fragmenting Europe to block Brussels' As the Antibot4Navalny collective, experts in the analysis and monitoring of Matryoshka campaigns, has warned , Matryoshka's latest bot campaign has targeted the upcoming November 29th elections in Spain. “The Spanish economy could be saved if the country leaves the EU”, says one of the posts published by the campaign's bots, impersonating The Economist; “ Catalonia should demand independence”; “Germany should split into West and East Germany ,” says another, supporting the idea of ​​separatism in European countries and attributing it to France24. In this way, the bots that make up Operation Matryoshka are publishing content on X in order to spread narratives and manipulate public opinion ahead of the November 29th elections in Spain. Antibot4Navalny has detected three blocks of narratives: “Useless elections” with content such as “ the housing crisis is just the tip of the iceberg: the economy is doomed, the elections will not help” ; “Redirection of funds intended for Ukraine and abandonment of the EU”, with statements such as “Europe’s economic collapse is a direct result of financial support for Ukraine”, And the “anti-Russian” sanctions and the “fragmentation of Europe to block Brussels”: with content that states that Germany should be divided again into East and West, and Catalonia should demand its independence”. 🧵 Today’s Matryoshka bot campaign targets Spain's Nov 29 vote. 💬 The housing crisis is the tip of the iceberg: the economy is doomed, elections won’t help. 💬 The real "solution": leave the EU, lift sanctions, split off Catalonia (sic!). Here's how the logic unfolds ⤵️ https://t.co/xQsAU1iu2o — bot blocker | блокировщик ботов (@antibot4navalny) November 11, 2026 This content, generally videos, impersonates Spanish media outlets such as El País or El Mundo , copying their style and typography. In this way, they attempt to spread disinformation among the public. Impersonating media outlets and journalists is one of the most common tactics used by Russian propaganda to disseminate its campaigns. Content impersonating El Mundo and El País, respectively. Source: Antibot4Navalny Antibot4Navalny has provided Maldita.es with these and other videos from this campaign, as well as several posts that have already been removed from the platform. Furthermore, some of these accounts have already been suspended for violating the platform's rules. Some of the posts from this campaign identified on X, which have since been deleted. Source: Antibot4Navalny As can be seen in the images, the stories in the videos impersonating El Mundo and El País are similar, and in both cases they spread a similar message: Spain has socioeconomic problems and the only thing that can save it is lifting the sanctions against Russia. They also mention France, which will hold presidential elections in 2027 . Screenshots of the video that impersonates El Mundo. Source: Antibot4Navalny Captures of the video that impersonates El País. Source: Antibot4Navalny Other videos, in English, that impersonate Euronews , AFP and Reuters or The Economist spread similar narratives presenting a socio-economic problem in Europe that can only be solved by Russia and by leaving the EU. Other content from this campaign detected on X. This is not the first time that Operation Matryoshka has created a campaign targeting Spain Following the blackout of April 28, 2025, the bots of Operation Matryoshka launched a campaign exploiting the event to spread the message that the blackout was due to EU sanctions imposed on Russia as a consequence of its invasion of Ukraine. On this occasion, they impersonated the British newspaper The Independent and France 24. Operation Matryoshka, meaning "Russian doll" in English, was discovered in January 2024 by AFP Factuel and the Antibot4Navalny collective . It has been circulating on X since at least September 2023, according to the French public monitoring agency Virginum . The goal is to publish false content, i.e., disinformation, and share it in a coordinated manner on X, "in the replies section of posts from media outlets, public figures, and fact-checking organizations in more than 60 countries", asking if they can verify the content. Other times, the content is published directly by bots that share it and tag different media outlets , with the same objective. Virginum adds that it's common for the fake content they share to "impersonate public figures and media outlets in the United States and Europe". As Maldita.es explained previously, the bots in this operation are fake accounts that are only used once and then remain inactive . In other cases, like this one, the accounts appear to be suspended . Operation Matryoshka has also been known on other occasions as Operation Overload , which is simply an extension of Matryoshka including the use of mass mailings to fact-checkers, news agencies and media outlets, asking them to verify content. No dejes que la desinformación vote por ti. Los desinformadores buscan que dejes de creer en todo: están coordinados y empujan una agenda propia. En Maldita.es te damos las herramientas para que los bulos no te roben la capacidad de decisión. Hacerles frente cuesta, y mucho. Crear bulos y destruir la confianza de la sociedad es barato, pero luchar contra ellos y reconstruir requiere conocimiento, tiempo y recursos. Maldita.es nació gracias a ti y sigue viva con tu apoyo. Aquí no mandan los intereses, manda la comunidad y el bien común. Únete a la comunidad que le planta cara a la desinformación. Cada euro suma: dona lo que puedas. Cada cuánto Una vez Pago puntual Cada mes Apoyo continuo Cada año 1 cobro anual Cuánto quieres aportar € Introduce un importe entre 5 € y 10.000 €. Pago seguro · desgrava en el IRPF

Silenciar…
Descansar…

Ayer

Me preguntaron algo en alemán en la caja de un súper. Mis AirPods me chivaron qué querían (se abre en una pestaña nueva)

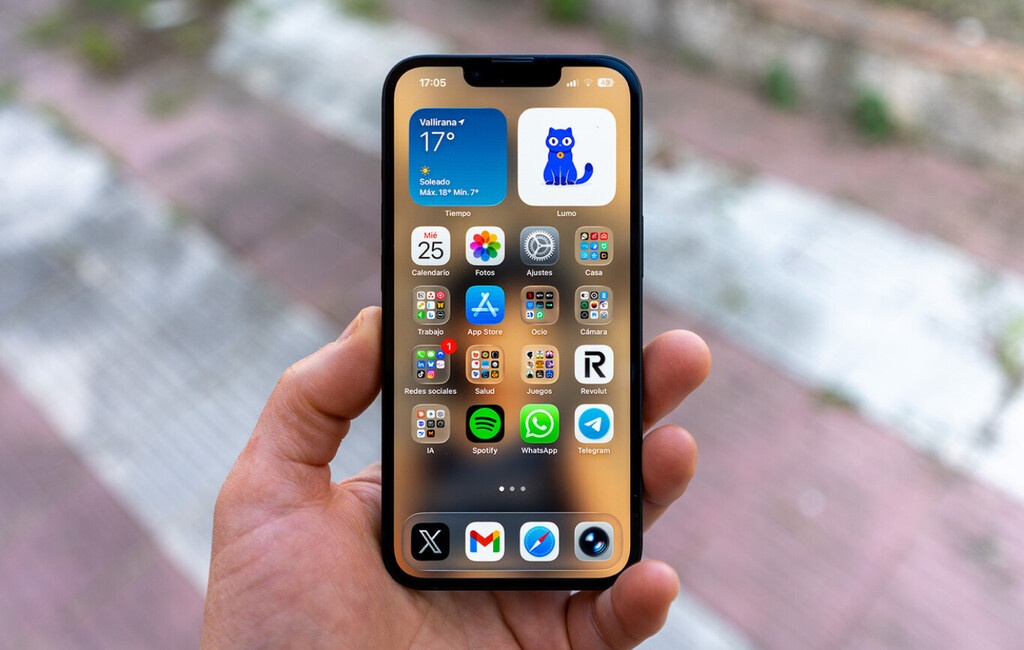
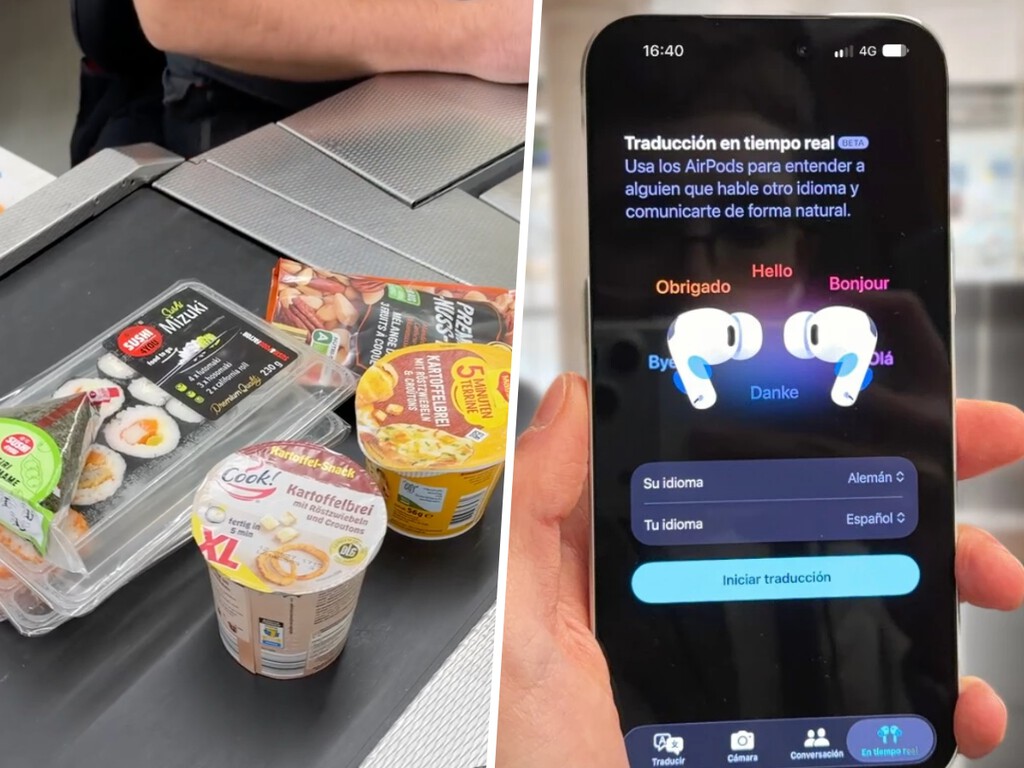
Viajar a un sitio donde no entiendes ni una palabra de lo que te dicen siempre da algo de miedo. Gestos, sonrisas y el dedo señalando lo que queremos se convierten en el idioma universal que casi nunca falla. Pero llega un momento en que alguien te hace una pregunta y no sabes ni qué te están diciendo. La traducción en tiempo real de los AirPods nos ayuda precisamente con esto y da mucho gusto usarla. Llevas la traducción en el oído, sin abrir ninguna app, mientras la otra persona te habla. Ya la probé en Viena el año pasado con una beta de iOS instalada y ahora, un año después de su lanzamiento, he vuelto a usarla. Esta vez sin beta de por medio y en dos idiomas distintos. Me he movido por Estrasburgo (Francia) y después he cruzado a Alemania para ir al parque de atracciones Europa Park. De francés y de alemán no sé más que hola, gracias y buenos días. Son sitios menos turísticos que una gran capital como París, por lo que era el momento perfecto para saber si esta función sigue igual que cuando se estrenó o si en este tiempo ha mejorado. Los AirPods y el iPhone que necesitas para que funcione Lo primero que hace falta para que la traducción en tiempo real funcione son unos AirPods y un iPhone compatible: Necesitas un iPhone 15 Pro en adelante porque requiere de Apple Intelligence. Después, unos AirPods Pro 2, Pro 3, AirPods 4 con cancelación activa de ruido, AirPods 5 o los AirPods Max 2. El software tiene que ser iOS 26.2 o superior, que es la versión en la que la función llegó a todo el mundo. Teniendo en cuenta que ya estamos por iOS 27.2 , lo mejor es que actualices a esta versión. Con todo esto, hay varias formas de utilizarlo: con la app Traducir del iPhone y dentro de la pestaña "Traducción en tiempo real" . O directamente con los AirPods puestos. Que es lo que te voy a comentar a continuación. Los dos AirPods pulsados y a escuchar Lo mejor de esta función es que no tienes que abrir ninguna aplicación de traducción, aunque está ahí si la quieres usar. Basta con que lleves los AirPods puestos y mantengas presionados los dos palitos a la vez, uno con cada mano . En ese momento se activa la traducción y desde ahí solo queda escuchar: Siri te va diciendo en español lo que la otra persona te dice en su idioma. El sistema usa los micrófonos de los AirPods y también los del iPhone para capturar mejor la conversación, así que interesa tener el iPhone en la mano. En una tienda o en un supermercado eso no tiene nada de raro, porque quien más y quien menos lleva el iPhone entre los dedos. La diferencia con un traductor de los de siempre es que es mucho más sutil . No te quedas ahí plantado, como un pasmarote, enseñando la pantalla o poniéndole el móvil en la cara a la persona para que hable. Todo es mucho más natural. Y cuando te toca hablar a ti, el iPhone también captura lo que has dicho y lo muestra en pantalla. Así que, si hace falta, se lo enseñas a la camarera y listo. Ahí sí funciona como una traducción normal, solo que con los AirPods puestos y la función activa desde el primer segundo. Del avión a la pastelería, así me ha ido La primera prueba llegó en el avión, cuando salí de Barcelona. El vuelo venía con tripulación francesa, así que las instrucciones de seguridad llegaron directamente en francés y en inglés. El inglés se entiende, pero fue un buen momento para ponerlo en marcha y funcionó muy bien. Mientras escuchaba música, activé la traducción y Siri me fue contando lo que decían sin que yo tuviera que hacer nada más. Donde más se nota la utilidad es en las traducciones cortas del día a día. Entré en una pastelería y me expliqué por señas: señalé lo que quería, hice con los dedos el número dos, enseñé la tarjeta de Apple Pay y pagué. Pero a ti te hablan. Dices un bonjour y poco más. Lo "bueno" es que ven enseguida que eres turista y entonces te siguen hablando algo más alto y lento. Pero el problema es que tú no te enteras de nada. Con los AirPods puestos, Siri te lo dice y tú respondes lo que toca. En Applesfera He probado las alternativas a Apple Pay por si algún banco decide quitarlo En un supermercado de Alemania me pasó algo parecido. L o habitual es decir sí o no, pero yo no sabía qué me estaban preguntando : si quería bolsa, si no quería bolsa, si quería ticket o si no lo quería. No supe ni lo que era ticket en alemán. Y lo mismo pasa con esas promociones que tienen en la caja, que no entiendes ni de qué van. ¿Quieres o no quieres esos donuts de oferta? Con la traducción activa, Siri te lo dice, tú respondes sí, no o gracias, que son palabras que te aprendes enseguida, y no necesitas nada más. Donde sigue fallando: megafonías y barullo La traducción en tiempo real tiene límites y en este viaje los he encontrado. Tienes que estar cerca de la fuente del sonido o, al menos, esta tiene que sonar relativamente bien. Con una persona delante no hay ningún problema, pero si estás en un restaurante con mucho barullo y la camarera te habla desde el otro lado de la mesa , vuelves a tener el mismo problema que con cualquier micrófono. Lo peor han sido las megafonías. Me pilló una huelga de transportes en Francia y el conductor anunció que el servicio terminaba en esa parada y que no continuaba. Yo no me enteré de nada y la traducción tampoco me sirvió, porque ya sabemos cómo suenan los anuncios del transporte público . Cuesta entenderlos en tu propio idioma, así que capturarlos para traducirlos a otro es pedirle demasiado. Un año después, ni mejor ni peor ¿He notado mejoría respecto a la primera vez? No. Tampoco iba mal entonces y tampoco va mejor ahora. Lo que más te encuentras son barreras humanas y la tecnología ahí no puede hacer mucho. Sí hay un punto en el que Apple podría mejorar, que es la velocidad . La traducción llega con unos dos o tres segundos de retraso, sobre todo al empezar. Cuando ya ha cogido el hilo de la conversación funciona algo mejor. Sabemos que Apple está avanzando en inteligencia artificial, pero aun así se nota la diferencia con otras herramientas: la transcripción de ChatGPT o la de cualquier otra IA suele ser mucho mejor que el dictado del iPhone, incluso en nuestro idioma. La traducción en tiempo real funciona como ese dictado y le faltaría rapidez y algo más de inteligencia para completar frases que no ha escuchado bien, usando el contexto o las palabras anteriores para entender de qué se habla. Entiendo que tendría que avisar de que es una traducción generada con IA y que puede contener errores, pero prefiero que me dé la frase completa antes que captar solo dos palabras. Esa sería mi petición a Apple. Todo esto me da mucho que pensar sobre el futuro . Cuando se estandarice, cuando mucha más gente lleve unos AirPods compatibles, esta función será todavía más natural. Y me imagino las gafas de Apple sin necesidad de llevar los AirPods, traduciendo tanto lo que ves como lo que oyes con Visual Intelligence. Seguro que Apple está recopilando muchísimos datos de estas traducciones y, cuanta más gente las use, mejor funcionará. La próxima vez que me toque perderme en un idioma que no conozco, los AirPods irán puestos. Y ojalá para entonces también sepan rellenar los huecos que no escuchen bien. Imágenes | Applesfera En Applesfera | Cómo tener la nueva Siri AI en España: guía paso a paso para esquivar el bloqueo En Applesfera | Nuevo iPhone 18e - Todo lo que creemos saber sobre el próximo móvil "barato" de Apple - La noticia Me preguntaron algo en alemán en la caja de un súper. Mis AirPods me chivaron qué querían fue publicada originalmente en Applesfera por Guille Lomener .

Silenciar…
Descansar…

Hace 2 días

Apple lanzará tres nuevos iPhone en cuatro meses y la filtración ya deja al descubierto cómo serán (se abre en una pestaña nueva)

Durante casi dos décadas, el calendario de lanzamientos de Apple ha funcionado con cierta precisión: en septiembre llegaba el relevo generacional para toda la familia. Ahora bien, tras cerrar este 2026 con la presentación más solitaria de los iPhone 18 Pro y el iPhone Duo, la ausencia del modelo base confirmó un cambio de ciclo . Fragmentando sus anuncios, los primeros de 2027 prometen bastante . Y los datos filtrados sitúan en marzo la ventana elegida para una oleada de nuevos iPhone. La firma de Cupertino prepara el desembarco de tres dispositivos con diferentes propósitos : el iPhone 18 a secas, una puesta al día en el no tan económico iPhone 18e y la segunda generación del ultrafino iPhone Air . iPhone 18: así será el modelo base Hasta esta generación, nunca antes había debutado una gama 'Pro' sin venir acompañada por el modelo de entrada. Sin embargo, la hoja de ruta para el año que viene sitúa su puesta de largo en primavera. El objetivo de este retraso habría sido maximizar las ventas de los premium durante la campaña navideña antes de desplegar el resto del catálogo. En lo técnico, su principal atractivo residiría en su chip: el Apple A20 , una variante que recortará un núcleo de GPU frente al A20 Pro. Vendría acompañado de 9 GB de RAM, una configuración atípica pero justificada para las funciones de IA locales. Y en el frontal, repetirá un panel OLED de 6,3 pulgadas con 120 Hz, adoptando las dimensiones reducidas de la Dynamic Island presentes en los iPhone 18 Pro. Por su parte, el módulo de cámaras continuará apostando por un doble sensor: IMX905 de 48 MP, firmado por Sony, como cámara principal. iPhone 18e: ya no es tan barato El relevo del iPhone más accesible llegará en forma de iPhone 18e, heredero también de la antigua gama 'SE'. Este compartirá chip con el iPhone 18 al incorporar el mismo hardware de rendimiento: A20 y 9 GB de RAM. La diferencia estará en el cuerpo y en la pantalla: panel OLED de 6,1 pulgadas y una Dynamic Island más tradicional . En Xataka Móvil Apple no dio especificaciones en la presentación del iPhone Duo. Pero la etiqueta de la UE acaba de sacar a la luz su letra pequeña En su trasera, montaría una única cámara de 48 MP , mientras que la frontal podría alcanzar los 18 o 24 MP. Sin embargo, el encarecimiento de las piezas —y las memorias— que ya situó al iPhone 17e en 859 euros anticipa un escenario poco halagüeño para el bolsillo. La crisis invita a prever que el iPhone 18e mantenga esa cifra o incluso la suba. iPhone Air 2: corrección en batería y cámaras La segunda generación del ultrafino busca enmendar dos apartados muy criticados del original . El iPhone Air 2 mantendrá un perfil delgado como seña de identidad, pero rediseñaría su interior para albergar hasta 3.500 mAh (3.149 mAh tiene el iPhone Air). Render conceptual con el diseño filtrado del iPhone Air 2 En cuanto a fotografía, integraría un sensor ultra gran angular de 48 MP que acompañaría a la lente principal , poseyendo por primera vez dos cámaras en este modelo. El panel conservaría las 6,5 pulgadas OLED a 120 Hz, reduciendo lo que ocupa la Dynamic Island y equiparando el A20 Pro para situarse por encima de los iPhone 18 y 18e en potencia. Un calendario que ha cambiado: ahora con dos ventanas Este triple lanzamiento conformaría la primera mitad del año para la telefonía de Apple. La primavera quedará reservada para estos : modelo base, variante económica y el formato compacto, acompañados previsiblemente por renovaciones de MacBook Neo y iPad. Por su parte, en otoño se concentrarán los iPhone más premium, la esperada edición conmemorativa del vigésimo aniversario y la futura iteración del plegable iPhone Duo. Sí, los tiempos han cambiado, pero escalonar el catálogo permite a Apple sonar cada pocos meses y amortiguar los ciclos de renovación sin apostarlo todo a una presentación anual. Imagen destacada | Iván Linares para Xataka En Xataka Móvil | Comprar el iPhone más caro siempre garantizaba tener el mejor. El nuevo iPhone Duo acaba de romper esa regla - La noticia Apple lanzará tres nuevos iPhone en cuatro meses y la filtración ya deja al descubierto cómo serán fue publicada originalmente en Xataka Móvil por Pepu Ricca .

Silenciar…
Descansar…

Hace 4 días

La IA vino para hacer mejor nuestro móvil. De momento ha matado al modelo más avanzado de Oppo (se abre en una pestaña nueva)

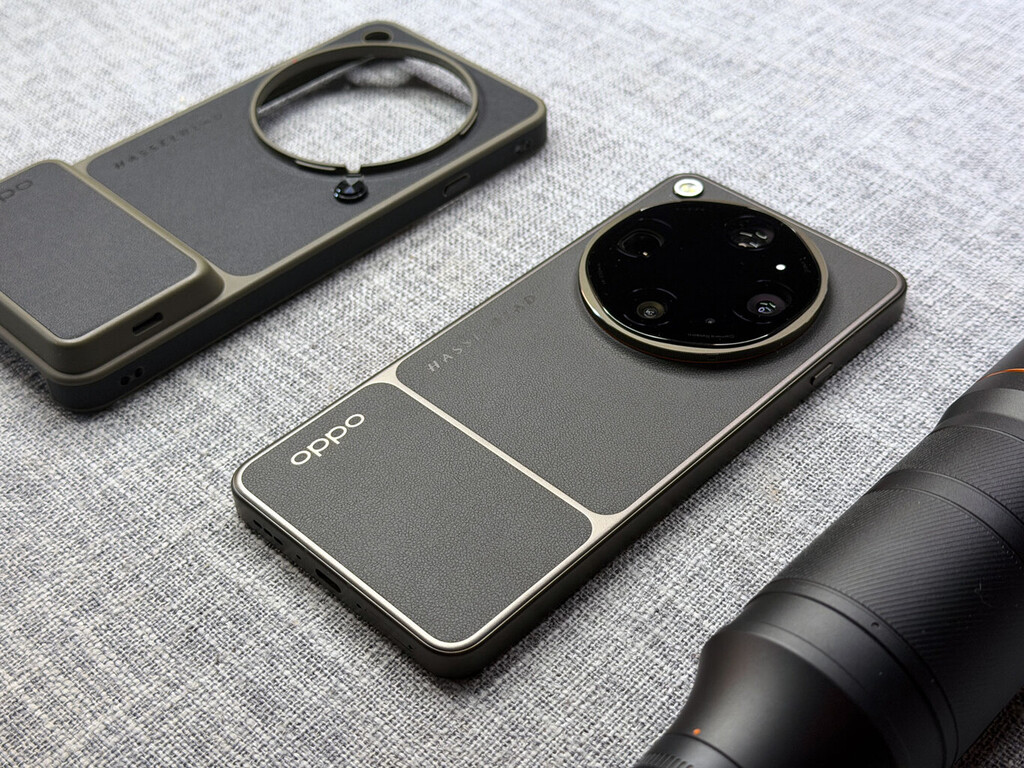
La narrativa aseguraba que la IA transformaría la experiencia con nuestro teléfono. Y lo está haciendo en cierta medida, no obstante, la presión en las fábricas impone una realidad distinta : la crisis en el precio de las memorias amenazaba con disparar los precios y las exigencias de los centros de datos han terminado asfixiando incluso planes de lanzamientos. El freno al móvil más ambicioso de Oppo sigue sonando con fuerza. Pese a que la llegada del Oppo Find X10 Pro Max —junto al modelo base— fijó un listón en fotografía de primer nivel , la marca habría optado por suspender el lanzamiento del Find X10 Ultra : porque asumir configuraciones de hasta 16 GB de RAM suponía elevar el precio a cantidades inviables. Buque insignia, congelado . La información parte de una filtración en Weibo que señala la paralización del modelo premium de la firma china. El terminal apuntaba a un sensor de 200 MP con tecnología LOFIC y dos telefotos periscópicos. Sostener este despliegue exigía también un chip a la altura y mucha RAM. Una combinación insostenible con los costes de producción actuales. Barrera de precio . ¿A cuánto apuntaba el Find X10 Ultra? Pues bien, viendo que el 'Pro Max' ya se sitúa en los 1.800 euros, lanzar un escalón superior sin recortes obligaba a superar esta cifra. En esa franja de precio, el margen de ventas no compensaría el coste de fabricación. ¿Costaría 2.000 euros? ¿Algo más? Lo cierto es que sería un terreno inhóspito donde conseguir volumen de ventas no es nada sencillo. Y sí, esta supuesta decisión tiene una explicación que seguramente conozcas. El motivo . La raíz del problema de la crisis de RAM se entiende rápidamente: la fiebre por los chips de IA ha obligado a los principales fabricantes a desviar su capacidad hacia la memoria HBM. El resultado, las memorias destinadas a dispositivos personales, como la LPDDR5X para smartphones, ha duplicado su precio en cuestión de meses. Y esto ha forzado a los fabricantes a repensar sus movimientos. En Xataka Móvil La crisis de las memorias ha terminado de apuntalar lo que ya era un hecho: Xiaomi no es la marca barata que conocíamos Renuncias . La presumible cancelación del móvil de Oppo no es algo inédito, sino un síntoma más de la industria. La decisión recuerda a la maniobra de Nothing al renunciar a su móvil estrella este año. Pocas semanas después, para su submarca, CMF, tampoco hubieron buenas noticias : paralizó sus lanzamientos económicos ante la evidencia de que la memoria representaba más de la mitad del coste de los componentes. Y repliegue . El peaje que la IA está cobrando al hardware que tenemos en el bolsillo ha llegado incluso a forzar despedidas. La retirada de Asus evidenció que competir en un mercado con márgenes mínimos no compensa para firmas con menos ventas. Paradójicamente, la tecnología que está abriendo posibilidades nunca antes vistas ha comenzado por encarecer un componente crucial para nuestros dispositivos. Ahora, hay un frenazo en seco, y no solo en los móviles baratos, sino en los más avanzados. Veremos cómo repercute esto en la marca: su rival más directo, dentro del consorcio BBK, sí planea lanzar el Vivo X500 Ultra. Imagen destacada | Amparo Babiloni para Xataka En Xataka Móvil | Nothing se postula como el gran fabricante móvil europeo. Es el único que lo tiene (casi) todo - La noticia La IA vino para hacer mejor nuestro móvil. De momento ha matado al modelo más avanzado de Oppo fue publicada originalmente en Xataka Móvil por Pepu Ricca .

Silenciar…
Descansar…

Hace 5 días

Destacadoeldiario.esCultura

Xavier Nueno, escritor: "Detrás de las grandes tecnológicas hay una cultura de saqueo y rapiña" (se abre en una pestaña nueva)

El autor de 'La revuelta de los copistas', flamante premio Anagrama de ensayo, defiende un nuevo y renovado proyecto de biblioteca pública que blinde el conocimiento de los intereses económicos El anterior Rincón de pensar - Evan Friss, historiador: “Lo que la gente aprecia de una librería es lo contrario de Amazon" Como un espigador que recoge el trigo olvidado en un campo tras la siega, Xavier Nueno (Barcelona, 1990) ha buceado en archivos de los últimos 150 años para lanzar una advertencia: la privatización del conocimiento está alcanzando un peligroso grado de no retorno con la generalización de la inteligencia artificial, que requiere de un urgente control público. El escritor ha plasmado esta tesis en La Revuelta de los copistas (Anagrama) , una obra valiente y extraordinariamente bien documentada que le ha valido el premio Anagrama de ensayo. El libro se presenta este martes en Barcelona . Su libro empieza fuerte: “El mayor robo de propiedad intelectual de la historia tuvo lugar a plena luz del día”. ¿El ladrón actuó solo o en compañía de otros? Fue un robo poco sofisticado y que se consumó prácticamente con un solo clic. Las compañías tecnológicas descargaron ilegalmente las llamadas bibliotecas fantasma, herederas de la cultura abierta y que ponían a disposición de los usuarios todas las nuevas publicaciones y las ya existentes, como si se tratara de una biblioteca pública. Algunas contenían millones de documentos protegidos por las leyes de propiedad intelectual. Las compañías tecnológicas se aprovecharon de esta cultura abierta, la descargaron y la privatizaron, encerrándola en sus centros de datos. Y ahora nos alquilan y ofrecen su contenido a cambio de una cuota. ¿Podríamos decir que es un robo que continúa, de alguna manera, a día de hoy? Sí. Cuando se publique esta entrevista, los bots de las compañías de inteligencia artificial la digitalizarán y la introducirán en sus servidores. Cuando alguien busque “Oriol Solé” o “Xavier Nueno” en Google o una IA, le aparecerá un resumen y ya no irá a la página de elDiario.es. O sea, también nos robarán esta entrevista. ¿Es un robo que todavía nos cuesta ver más que uno más clásico y tradicional, como un tirón de un bolso por la calle? Es verdad que los litigios que hay en marcha en EEUU y en Europa aquí están pasando un poco desapercibidos. Los grupos editoriales y los medios europeos tienen abiertos litigios de todo tipo con las empresas tecnológicas. En EEUU, todavía se están instruyendo. Son casos gigantescos, así que creo que tardarán años en resolverse y pasarán por muchas instancias. ¿Sobre qué versan estos juicios? Los demandantes son periódicos, autores, sociedades de autores y todo el sector editorial. Se dirime si los resultados que ofrecen los modelos de lenguaje de IA cuando haces una búsqueda o introduces un prompt infringen los derechos de autor. Las compañías tecnológicas sostienen que lo que hacen es entrenar unos modelos con estas bibliotecas y que después los modelos producen conocimiento nuevo. Pero, a mi juicio, no está nada claro que sea así. Yo creo que lo que hacen es buscar dentro de la biblioteca y servirte un conocimiento que ya existía. ¿De qué manera se puede refutar esta justificación de las tecnológicas de que producen un nuevo conocimiento? Hay que obligar a las tecnológicas a abrir sus catálogos. En el momento en que veamos con qué textos se han entrenado, nos daremos cuenta de que, en realidad, las inteligencias artificiales no son tan inteligentes. Son unas máquinas de búsqueda extraordinarias, con una capacidad de indexación del conocimiento realmente impresionante, pero no tienen capacidad para producir conocimiento nuevo. En realidad, las inteligencias artificiales buscan y modifican un texto ya existente lo suficiente para que lo que nos ofrecen quede por debajo del umbral de infracción de los derechos de autor. Lo transforman lo justo para que nos parezca un conocimiento nuevo y, sobre todo, para que no tengan que pagar derechos por ese conocimiento. Hemos sustituido un criterio personal, cultural e intelectual por las simples métricas de impacto que tienen los artículos Su libro, además, explica que no hemos llegado por casualidad hasta aquí, sino que el avance tecnológico profundiza la pérdida del juicio del conocimiento que ya había empezado mucho antes de la IA. Es un reto escribir una historia de este tipo porque implica cambiar el foco. Normalmente, los libros de tecnología siempre nos hablan de los tecnoligarcas y nunca nos cuentan nada de las personas que trabajaron antes de estos modelos. El libro está planteado como una historia del trabajo, de una serie de profesiones dedicadas a organizar y clasificar el conocimiento. A mediados del siglo XIX, esta tarea empieza a generar un pequeño beneficio. A partir de ese momento, se van construyendo unas industrias de una voracidad enorme, que intentan capturar el beneficio y automatizar el trabajo de las personas que lo producen. ¿Dónde comenzó este proceso? Empezó en el mundo de la jurisprudencia de los tribunales estadounidenses alrededor de 1850, y después abarca casi todos los campos del conocimiento científico. Constituye la matriz de la privatización de la biblioteca que estamos viviendo hoy, con proyectos primero como Google Books y los modelos de IA actuales. Es una historia de sucesivas privatizaciones, de cómo estas empresas han ido penetrando cada vez más profundamente en la biblioteca y son cada vez más capaces de extraer valor de ella. En esta historia del trabajo, una constante que también destaca el libro es la invisibilización del trabajo femenino. Suele haber unos pocos hombres que desarrollan proyectos de organización del trabajo y, después, muchas manos de mujeres que se dedican a organizar y clasificar el conocimiento. A finales del siglo XIX, para abaratar el coste de gestionar la información, se feminizó masivamente el trabajo de las bibliotecas. Se hizo siguiendo un esquema que también se repite hoy: llamar labor mecánica al trabajo de cuidar la memoria del mundo. Hoy son miles de manos invisibles en países pobres las que ajustan el algoritmo y producen este efecto de automatización. Hay una frase en su libro que creo que resume muy bien el momento actual: “Se publica más que nunca, pero no se sabe qué es importante”. No lo digo para afirmar que en el pasado se supiera mejor, pero creo que hoy existe una gran confusión en torno a los criterios de relevancia. Hemos sustituido un criterio personal, cultural e intelectual por las simples métricas de impacto que tienen los artículos: cuántas veces se han compartido y toda esta clase de dinámicas. Esto tiene unas consecuencias que todos conocemos. Los periódicos habláis a menudo de estos efectos y también los sufrís. Y no solo en un plano cultural o intelectual: cada vez hay más gente que pide a la IA que le escriba un correo del trabajo o le haga una lista de viajes de vacaciones. Me pregunto si cuando delegamos las tareas más cotidianas también perdemos la capacidad de hacerlas. Todos hemos tenido la sensación de que, si no encontrábamos una palabra, la IA nos la podía alquilar. ¡Si hasta si quieres escribir una carta de amor, la IA te da el esquema para hacerlo! Me preocupa estar alquilando aquello que es más común, más intrínsecamente nuestro: el lenguaje, la capacidad de expresarnos, de juzgar y de crear nuestro propio mundo a través de algo que no es solo nuestro, sino que es lo que nos hace humanos. Sacrificamos todo esto para no hacer el esfuerzo de acceder al conocimiento por nosotros mismos, con nuestras propias facultades. Nueno, junto a la biblioteca de elDiario.es en Barcelona durante la entrevista Lo interesante del libro es que su propuesta no consiste en volver a las cavernas, sino que estos distintos modelos de IA sean públicos. ¿Por dónde empezamos? Lo primero tiene que ver con la transparencia y la posibilidad, ahora casi inexistente, de auditar estos modelos de lenguaje. Los poderes públicos tienen que exigir que se publiquen los catálogos de las bibliotecas con los que se han entrenado las IA. Hacer públicos los catálogos fue una idea central en la formación de las bibliotecas públicas del siglo XIX. Lo que ofrecía la biblioteca pública era la posibilidad de que cualquier persona accediera a ella y pudiera consultar cuáles eran sus fondos. Los catálogos estaban disponibles para todo el mundo y cualquiera podía interactuar directamente con ellos. Hoy tenemos que exigir esta transparencia a las compañías tecnológicas porque es algo básico en los Estados democráticos: tienen que explicar de dónde procede toda la información que utilizan, qué parte de esa información está protegida por derechos de autor y cuál pertenece al dominio público. ¿Qué le parecen los proyectos para crear una IA pública ? Son proyectos que se están desarrollando en distintos países y creo que tienen bastante recorrido y son muy importantes. Pero no funcionarán mientras no exista una regulación de las compañías tecnológicas. Es imposible competir con empresas que no tienen ninguna transparencia. Esta es la otra pata: tenemos que definir qué es el dominio público, porque no es lo mismo la cultura abierta que la cultura pública. ¿Cuál es la diferencia entre ambas? La cultura abierta procede de la contracultura californiana. Es un tipo de cultura que se aleja de la pública, porque es muy antiestatal y busca desproteger y desregular. Es bastante parecida a una forma de anarcocapitalismo. Lo público no es lo mismo que lo abierto. Lo público siempre ha estado regulado: existen unos códigos legales que establecen cómo se puede acceder a todo este conocimiento. Dentro de esta cultura pública, lo que deberíamos garantizar es que no pueda haber compañías que extraigan todo este material, lo encierren en sus propias bibliotecas y en sus propios centros de datos y después nos lo vuelvan a vender o alquilar. Es una medida esencial y, al mismo tiempo, bastante asequible. Los proyectos de IA pública no funcionarán mientras no exista una regulación de las compañías tecnológicas ¿Si las tecnológicas publicaran sus bibliotecas, se les terminaría el negocio? Las compañías tecnológicas se resisten mucho a mostrar esta información. Que yo sepa, ninguna de las grandes empresas tecnológicas lo está haciendo, porque además están inmersas en litigios. Hay modelos un poco abiertos que muestran todos sus parámetros, que son millones, una vez ya se han entrenado con sus bibliotecas, pero no te dan acceso a ellas. Si algún día tenemos acceso a toda su biblioteca, veremos que la operación ideológica fundamental que lleva a cabo la IA es borrar las fuentes y presentarnos como si fuera suyo algo que en realidad procede de distintas fuentes. A partir del momento en que sus fuentes sean públicas y transparentes, como las de una biblioteca, las IA ya no nos parecerán tan inteligentes. Empezaremos a ver que, en realidad, son menos un oráculo y más una biblioteca. Funcionan como una biblioteca muy sofisticada, de la que podemos aprovecharnos y con la que podemos trabajar, pero debemos garantizar que su acceso sea realmente público. ¿Cómo se puede obligar a unas empresas que operan sin reglas, más allá de los costes legales de los litigios, a estar reguladas? Detrás de las grandes tecnológicas como OpenAI hay una cultura del saqueo y la rapiña. Lo vemos en este momento con los pánicos a las IA apocalípticas, que están siendo promovidos desde los propios consejos de administración de las empresas para conseguir los grandes contratos del Gobierno estadounidense. Si tienes una tecnología apocalíptica, el Gobierno querrá que haya muy pocas empresas que puedan garantizar el acceso a la información gubernamental. Este discurso apocalíptico sirve para ocultar las preguntas esenciales: los usuarios estamos pagando muy poco para acceder a estos modelos porque hay capital riesgo detrás que está intentando cerrar la biblioteca pública. Se está poniendo muchísimo dinero en esta especie de carrera para conseguir privatizar toda la biblioteca y toda la información. ¿Qué ocurrirá si tienen éxito y la biblioteca se privatiza del todo? Una vez que la biblioteca esté privatizada, el capital riesgo se retirará y los costes que todos tendremos que pagar para acceder a este conocimiento subirán. Este es el modelo de las compañías tecnológicas. Cuando Uber apareció, el trayecto costaba mucho menos que un taxi, pero no porque fuera más barato que el de un taxi, sino porque había inversores que estaban poniendo dinero en la empresa con la convicción de que, si conseguían destruir el negocio del taxi, podrían quedarse con todo ese mercado. Y, una vez que se hubieran quedado con él, subirían los precios. En elDiario.es descubrimos que una empresa compra libros viejos para entrenar a la IA y los destruye. Las compañías tecnológicas han arrasado con todo lo que podían de las bibliotecas. Cuando estas han empezado a poner límites y se han dado cuenta del enorme coste que supone regalar literalmente su tesoro a las compañías tecnológicas, ha surgido una alternativa: comprar libros de segunda mano. Estos libros literalmente los cortan por el lomo y los escanean a gran velocidad. Cuando empezó Google Books , todavía había una forma de cuidado del libro. Los libros se escaneaban haciendo fotografías verticales. Estos libros pertenecían a bibliotecas y las bibliotecas no permitían que Google les cortara el lomo. Pero, una vez que estos libros han dejado de contar con esa protección por parte de las bibliotecas, todos los libros de segunda mano que compran los destruyen inmediatamente: les cortan el lomo y los trocean, utilizando un escáner de alta velocidad que no necesita que otra persona vaya pasando las páginas. En las elecciones de esta semana en EEUU, varios analistas han vinculado la victoria, tras 38 años, de los demócratas en Texas con el malestar ciudadano por los centros de datos. ¿Que la gente note los efectos de esta tecnología en su día a día y sus facturas será decisivo para lograr este cambio? Es una de las claves. En el modelo de capitalismo actual, los oligopolios tecnológicos ofrecen cero retornos a la sociedad. Todo lo que nos devuelven es ruido y contaminación. Su uso de los recursos públicos del Estado, como las redes eléctricas o el sistema de aguas, es terriblemente abusivo y tiene unas consecuencias que son negativas para el conjunto de la ciudadanía. Estas externalidades las deberían pagar las compañías tecnológicas y no lo hacen. Debemos avanzar hacia un nuevo y un gran proyecto de biblioteca pública En Catalunya y en España, se plantea la implantación de centros de datos como sustitución de la industria tradicional . ¿Son una alternativa a una fábrica de coches que cierra? No son lo mismo. No hay nadie trabajando dentro de un centro de datos. Es una infraestructura que contará con tres o cuatro personas de seguridad y poco más. Me parece muy significativo que estemos destinando una inversión tan descomunal a los centros de datos y, al mismo tiempo, estemos desprotegiendo de una manera tan evidente y flagrante las bibliotecas, que son las que contienen el conocimiento que después se privatiza en esos centros de datos y que las compañías tecnológicas nos vuelven a vender. Debemos avanzar hacia un nuevo y gran proyecto de biblioteca pública. ¿Cómo tendría que ser este proyecto? La biblioteca pública no fue algo espontáneo. Nació en el siglo XIX, de las confiscaciones de los libros que estaban en los monasterios y de las colecciones que tenían los aristócratas. Durante la Revolución Francesa, el Estado se quedó con sus colecciones y también con las de los monasterios, y en España ocurrió algo parecido con las desamortizaciones de la Iglesia. Tenemos que entender que el proyecto de la biblioteca pública es un proyecto activo, que hay que defender en un sentido político, y avanzar hacia un horizonte que no siempre será el más cómodo. A las compañías privadas no les interesa que exista algo como la biblioteca pública. Preferirían que no existiera. Pero esta biblioteca pública debe tener unos parámetros diferentes de los que ha tenido hasta ahora. ¿Cuáles? No solo debe proteger el patrimonio bibliográfico, sino que también tenemos que pensar en todo lo que hacemos con los datos y con la transmisión del conocimiento. Todo lo que forma parte del patrimonio público del conocimiento del Estado —las bibliotecas, los archivos, la publicación científica, la investigación, las universidades...— está financiado con dinero público. No puede ser que todo este conocimiento se privatice inmediatamente después de publicarse y que nuestro acceso quede totalmente mediado por las grandes compañías, que lo regulan en función de lo que paguemos mediante una suscripción. Debemos proteger los recursos que los estados destinan a la investigación y a la educación, y evitar que puedan privatizarse en cuanto se ponen a disposición de los ciudadanos. Última pregunta. ¿Ha utilizado más IA o ha visitado más archivos presencialmente para este libro? Uso mucho la IA para buscar información. Como tecnología de búsqueda me parece muy potente. Pero para el libro tuve que conocer muy bien casos que tienen bastante sustancia, e incluso podríamos decir que son un poco freaks . Para estudiar estos casos, con la IA no basta, tiene un límite y he descubierto que, a partir de cierto punto, ya no sabe qué decir, lo que me ha reafirmado en que la IA no es un conocimiento infinito, sino un conocimiento muy limitado y contenido. La mayor parte de referencias de este libro proceden de material que no está digitalizado. Para hacer una investigación de este tipo, tienes que trabajar codo con codo con archiveros y archiveras y bibliotecarios y bibliotecarias. Son las personas que saben guiarte por un archivo con cajas y cajas de papeles y probablemente son las únicas que saben orientarse allí dentro. ¡Sin ellos no hubiera sido posible el libro!
Silenciar…
Descansar…
No se pudieron leer los feeds de Melilla Hoy, Granada Digital, Gasteiz Hoy, La Marina Plaza, El Bierzo Digital. El resto de medios se actualiza con normalidad.
Has llegado al final · 6 noticias

Suscribirse a esta búsqueda por RSS